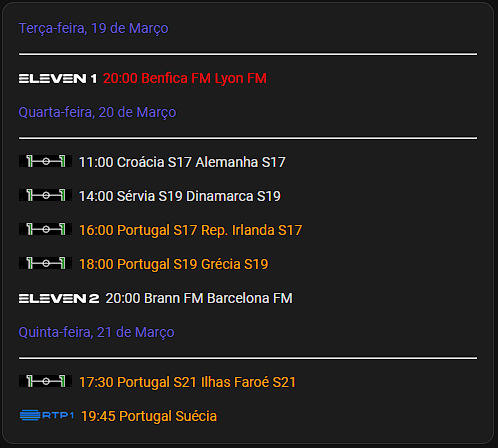
Esqueci-me de mencionar a atualização do Scrape’s sensor…
Não sei qual é o ratio de atualizações que tem de forma inicial/standard mas é boa prática desabilitar a actualização automática, indo à integração “Scrape”, e à direita do sensor carregar nos 3 pontos. Aí tens as opções:
Reload
Rename
System options
Disable
Delete
Vais a “System options” e desabilitas a segunda opção: “Enable polling for updates.”
A forma ideal é através de uma automatização:
alias: Scrape - Automation
description: ""
trigger:
  - platform: time_pattern
    hours: /12 #mete o número de horas,dias, etc., que desejares a actualização
condition: []
action:
  - service: homeassistant.update_entity
    data: {}
    target:
      entity_id:
        - sensor.fcporto #exemplo - altera para o que tens
mode: single
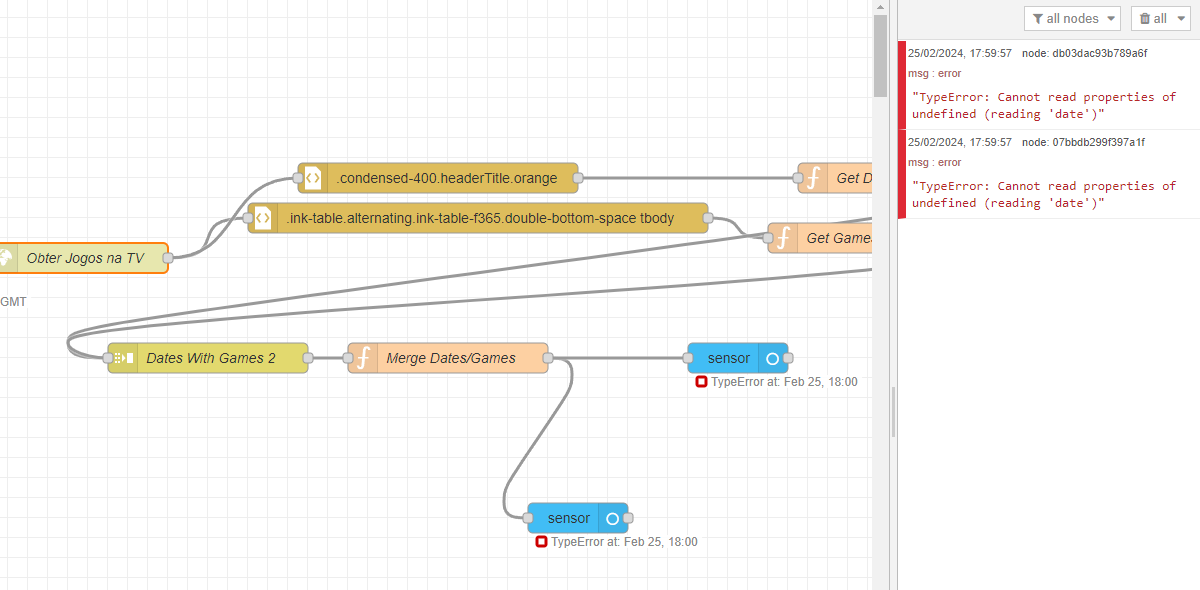
Boas, penso que o website teve uma atualização no dia 21/02/2024, deixou de funcionar no meu, não sei se mais alguém teve a mesma situação. Tive a ver se conseguia perceber onde estava o erro, mas não encontrei. Alguém encontrou e tem solução? Isto dá mesmo muito jeito
Bem, teve 3 anos a funcionar, alguma coisa devem ter mudado no site. Diariamente recebo a lista de jogos no telegram e deixei de receber. Nesta fase estou demasiado ocupado para fazer debugger e perceber o que mudou no site mas basicamente é preciso ver no nodered o que está a sair em cada nó para perceber onde houve a quebra e depois corrigir esse node. Conto resolver em breve.
A mim também deixou de funcionar desde o dia 21. A primeira mensagem que me apareceu no erro do node, era para atualizar o node red companion, agora instalado pelo hacs. Ao fim de fazer essa actualização, aparece então o verdadeiro erro do node de não funcionar. Alguma coisa a ver com a data!?
O fluxo começa pelo request ao site e depois tem 2 html nodes que fazem o parse ao site. Este parse está a vir a vazio. Verifiquei o site e o css onde está a informação associada das datas e jogos estão iguais. Testei outro flow que tenho para obter os preços dos combustiveis de um site e tambem o parse fica sem dados. Alguma coisa entre o request e parse que mudou e ainda nao percebi o quê mas vou continuar a explorar o tema.
Boa tarde.
O site deve estar a bloquear o scrape à página com os jogos na televisão. Utilizem o seguinte link para obter os dados: https://www.futebol365.pt/feed/aeiou/jogos-na-tv/
Deve resolver o problema.
Anyway…
Ultrapassando os 403’s codes com a adição de selenium ao script, e um argumento de headless-browser, ultrapassa isso mas nunca encontra elementos.
Resultados para element (“.table-futebol.table.table-bordered.table-stripped”)
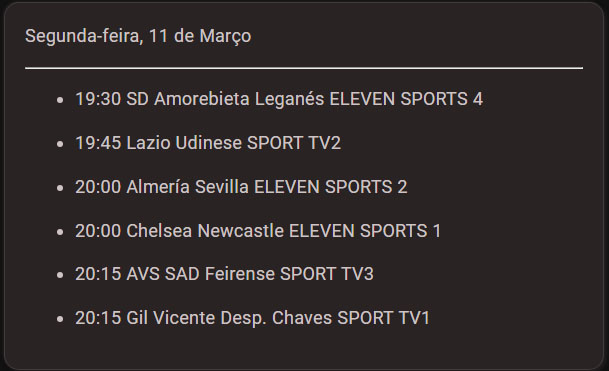
00:30 Nacional Asunción Palestino SPORT TV1
11:00 Valadares Gaia FM Marítimo FM CANAL 11
15:00 Sp. Braga S19 Sporting S19 CANAL 11
17:45 Sporting Atalanta SPORT TV1
20:00 Man City Kobenhavn ELEVEN SPORTS 2
20:00 Real Madrid RB Leipzig ELEVEN SPORTS 1
22:00 CD Everton Unión La Calera SPORT TV3
O que parece resolver o nosso problema. Agora é uma questão de alterar o flow.
Fiz umas experiências, mas não tenho o habito de utilizar node-red… melhor alguém tratar disso.
Aqui continua sem dar, penso que é na parte da extração também, fiz ali uns testes e aquela variable está a vir vazia, agora não percebo muito de como mudar isto sinceramente e está a fazer muita falta, usava muito isto para me guiar, agora tenho de ir ao sofascore eheheh
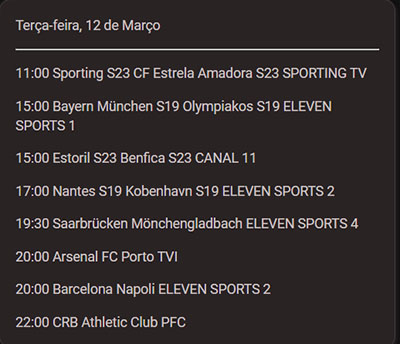
Muito obrigado pela ajuda. Funcionou, só retirei os pontos de início e substitui SPORTS por nada para não ficar muito grande quando é a Eleven Sports. Top
Tentei via node red até porque tenho 2 scrapes no mesmo site, um para obter os jogos e canais, outro para obter os jogos por competição e depois faço um cruzamento de dados mostrando o país e nome da competição.
Tentei diferentes bibliotecas de http request no node red mas não está a retornar o HTML da página. Vou continuar a explorar o tema.
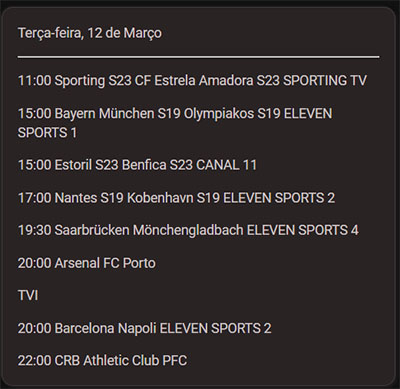
Com esse template já a fila com jogos a dar no(a) PFC (imagino que seja algum canal brasileiro) não aparece.
Assim só surgem jogos em canais portugueses.
edit: Uma boa idea será também alterar o “scan_interval: 10800” (3 em 3h) - o site parece não actualizar de hora em hora; e imagino que não queremos a repetição do outro site a “bloquear” scrape.
Boas, alguma coisa mudou no site onde estava a consultar a info dos jogos. Colocaram algum bloqueio que ao fazer o request, não está a ser possível ter acesso ao html da página.
Encontrei onde site semelhante e estou a construir um parser de forma a ter a informação semelhante. Quando concluir, partilho o flow e card.